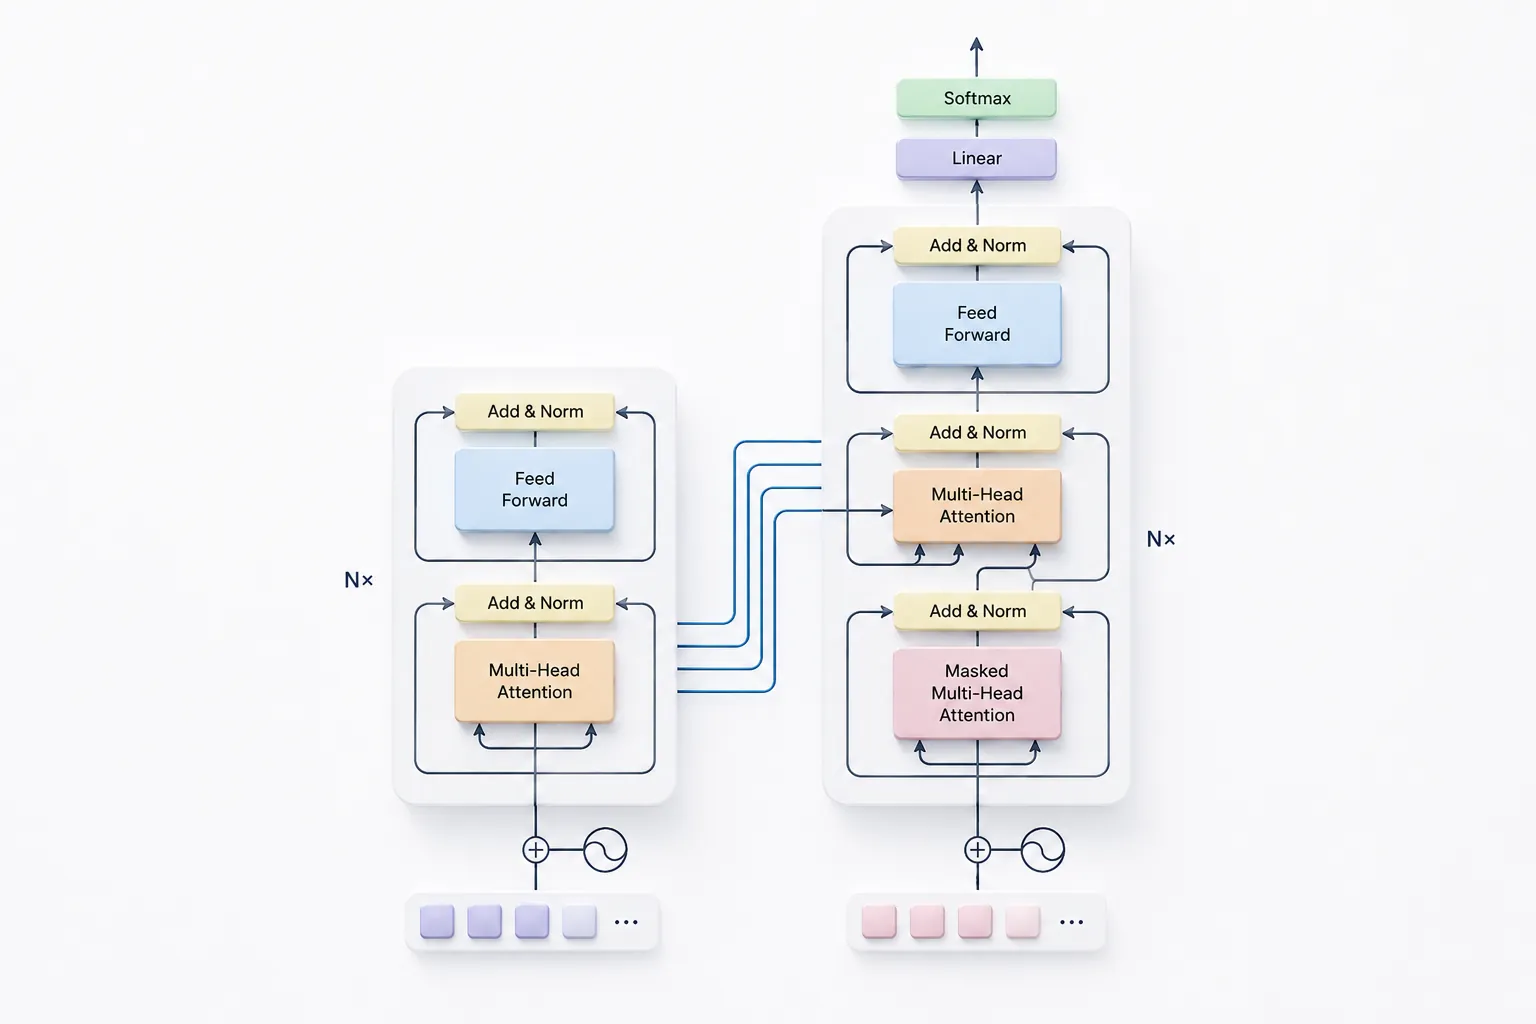
Transformers e LLMs: Como Funciona a Arquitetura que Revolucionou a Inteligência Artificial
Introdução
Em 2017, uma equipe de pesquisadores do Google publicou um artigo científico com um título ousado: “Attention Is All You Need” (Atenção é Tudo o Que Você Precisa), referência fundamental até hoje (Vaswani et al., 2017). Naquele momento, poucos poderiam prever que aquele trabalho técnico se tornaria o ponto de inflexão mais importante da história da computação moderna.
Até então, o processamento de linguagem natural dependia de arquiteturas sequenciais (como RNNs e LSTMs), que sofriam com dois problemas graves: lentidão no treinamento e incapacidade de lembrar relações entre palavras distantes em textos longos.
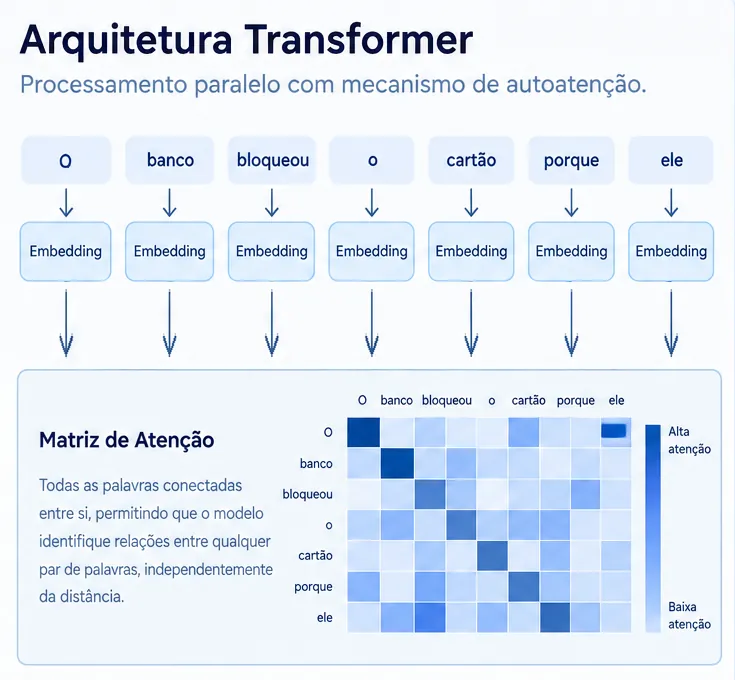
A introdução da arquitetura Transformer demoliu essas barreiras. Ao permitir que redes neurais processem frases inteiras em paralelo e calculem o peso relativo de cada palavra em relação a todas as outras simultaneamente, o Transformer tornou-se o alicerce absoluto de todos os Grandes Modelos de Linguagem modernos — do GPT e Claude ao Gemini, Llama, DeepSeek e ferramentas de geração de imagem e código.
Neste guia técnico e acessível, você entenderá o funcionamento interno do mecanismo de Autoatenção (Self-Attention), as diferenças entre modelos Encoder e Decoder, e as etapas fundamentais do ciclo de vida de um LLM.
O Problema das Redes Antigas e a Virada Histórica
Para entender a genialidade do Transformer, precisamos olhar para as limitações que existiam antes dele:
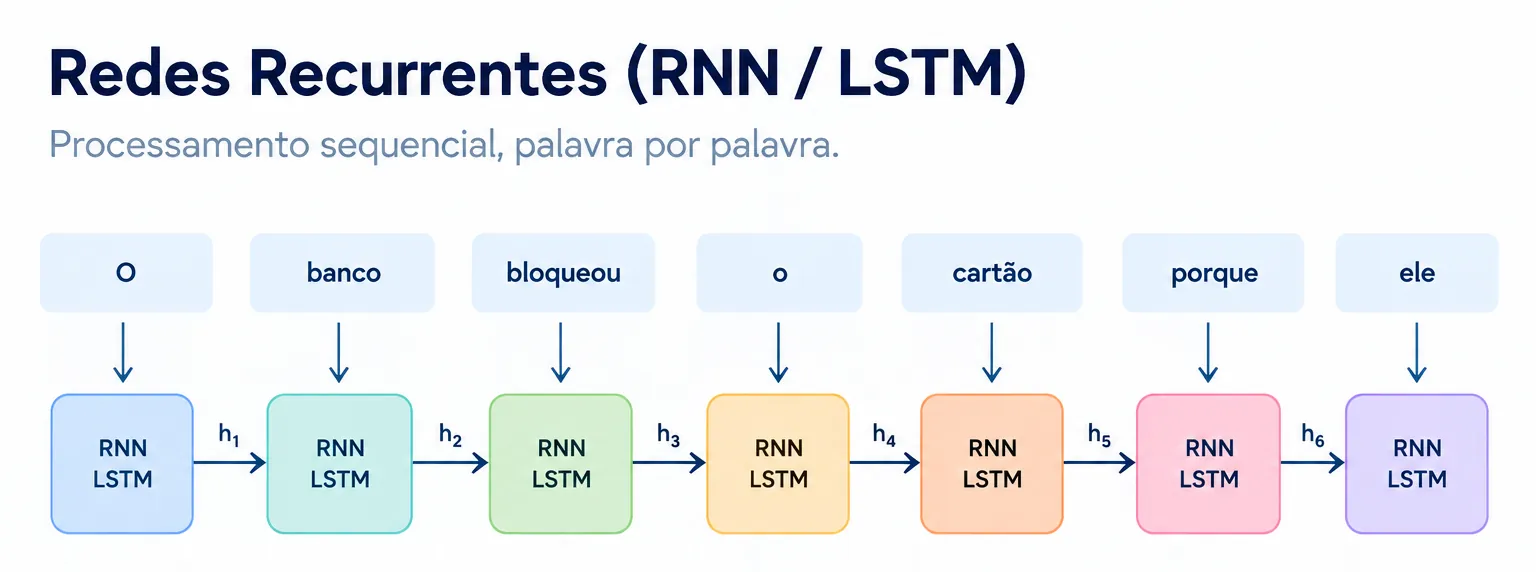
Principais Limitações:
- Gargalo Sequencial: Redes recorrentes precisavam ler a primeira palavra para depois ler a segunda, impossibilitando o uso eficiente de clusters massivos de GPUs modernas.
- Perda de Memória de Longo Prazo (Vanishing Gradient): Em parágrafos extensos, o modelo “esquecia” o sujeito citado no início da frase.
O Transformer resolveu ambos os problemas: eliminou a dependência sequencial (permitindo paralelismo massivo em hardware) e introduziu o cálculo direto de atenção entre qualquer par de palavras, independentemente da distância entre elas.
Tokenização: A Primeira Camada que Ninguém Vê
Antes de qualquer atenção ser calculada, porém, o texto precisa ser convertido em números. É o trabalho da tokenização, realizada por algoritmos como o BPE (Byte-Pair Encoding):
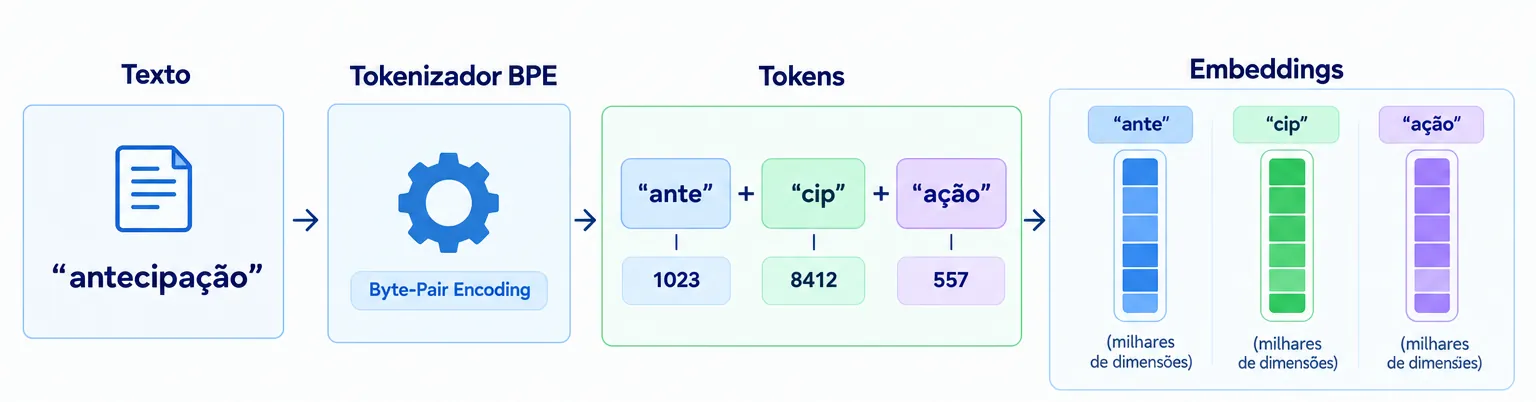
- Vocabulário: LLMs modernos operam com vocabulários entre 50 mil e 250 mil tokens, aprendidos estatisticamente durante o treinamento — o GPT-2 usava cerca de 50 mil, enquanto o Llama 3 adota 128 mil justamente para melhorar a cobertura multilíngue (Meta AI, 2024).
- Consequência prática: O modelo não enxerga letras, vê blocos. Isso explica por que LLMs historicamente falham ao contar quantas letras tem uma palavra ou fazer aritmética dígito a dígito — tarefas triviais para humanos, mas artificiais para quem lê em pedaços.
- Impacto em custos: Idiomas com maior fragmentação (como o português) tendem a gerar mais tokens por frase do que o inglês, encarecendo chamadas de API.
E a Ordem das Palavras? Encoding Posicional
Há um detalhe sutil nesse processo: os vetores de embedding carregam o significado de cada token, mas não a sua posição. Para um mecanismo que lê todas as palavras ao mesmo tempo, “o cachorro mordeu o homem” e “o homem mordeu o cachorro” seriam indistinguíveis sem um reforço extra.
A solução é somar a cada vetor um padrão numérico único, derivado da posição do token na sequência — o encoding posicional. Pense nisso como numerar discretamente cada palavra antes da análise. O modelo mantém o processamento paralelo sem perder a noção de ordem.
Com os tokens convertidos em vetores — e posicionados na sequência —, o modelo está pronto para realizar sua operação central: a autoatenção.
O Coração do Transformer: Mecanismo de Autoatenção (Self-Attention)
O conceito mais importante da arquitetura é a Autoatenção. Ela permite que o modelo decida, de forma dinâmica, quais outras partes do texto são mais relevantes para compreender o significado da palavra atual.
Considere as duas frases:
- “O homem sentou no banco da praça.”
- “O homem foi ao banco pagar uma conta.”
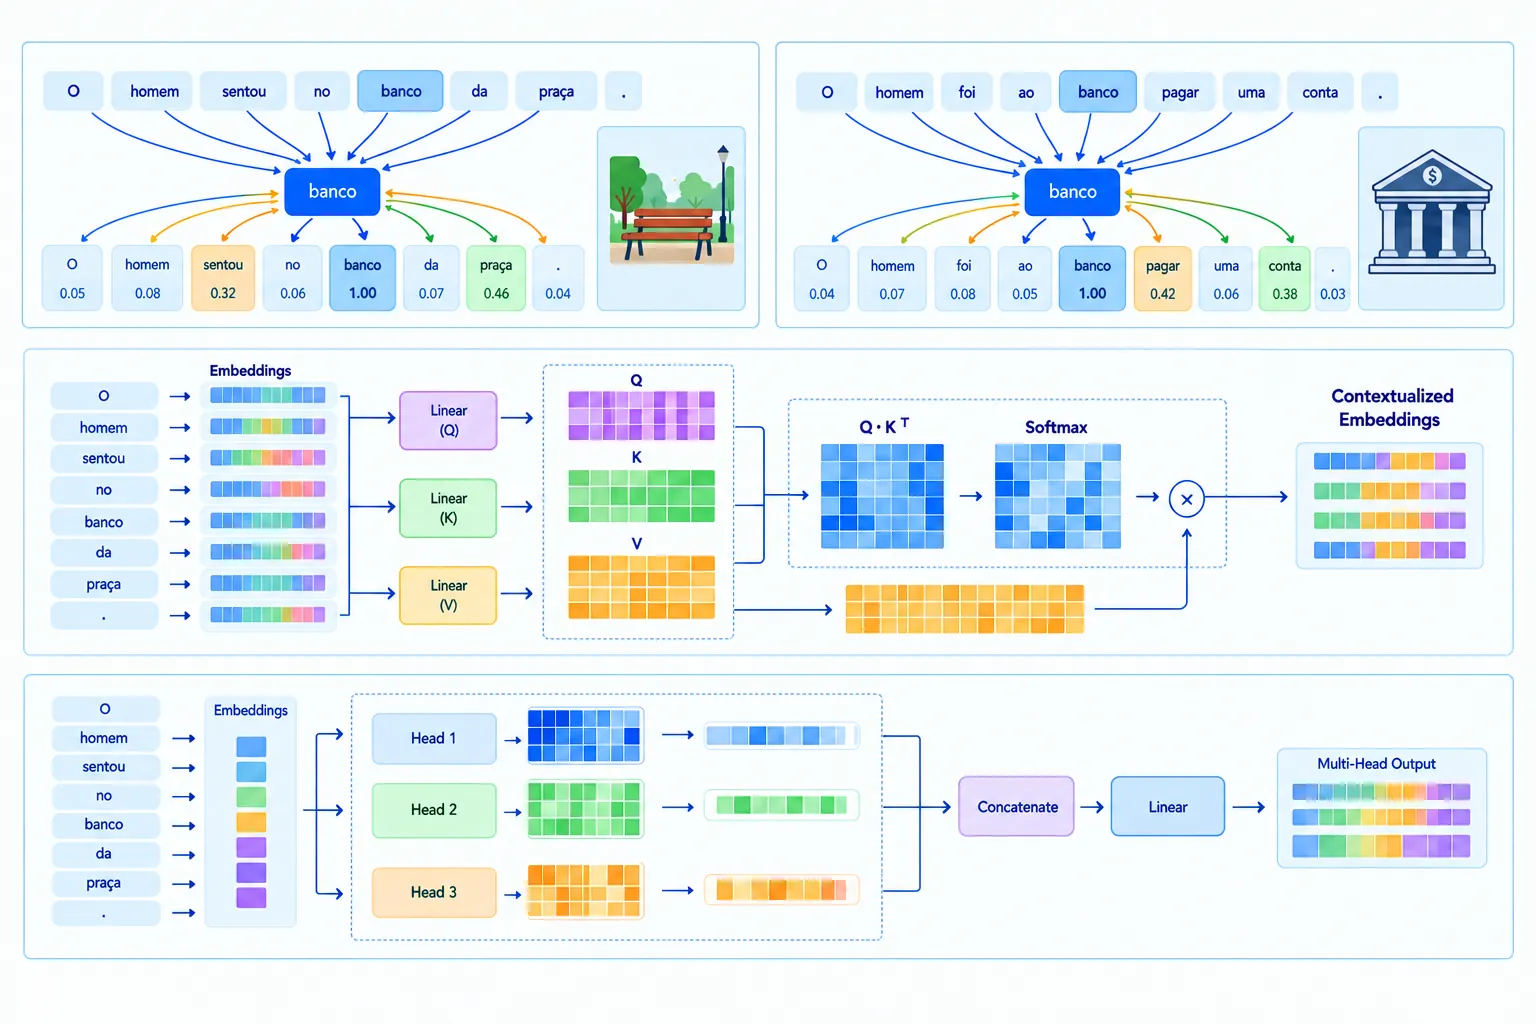
A palavra “banco” é idêntica em ambas. No entanto, o mecanismo de autoatenção calcula que, na primeira frase, “banco” deve dar alta atenção a “praça” e “sentou”, atribuindo-lhe o sentido de assento. Na segunda frase, a atenção recai sobre “pagar” e “conta”, atribuindo o significado de instituição financeira.
A Lógica por Trás da Atenção: Queries, Keys e Values (Q, K, V)
Para calcular a atenção, o modelo projeta cada token (aqueles fragmentos de texto criados pela tokenização) em três vetores conceituais, usando uma analogia similar a um sistema de busca de vídeos no YouTube:
- Query (Q - Pergunta): O que este token está procurando?
- Key (K - Chave / Etiqueta): Qual é o conteúdo e a identidade de cada um dos outros tokens?
- Value (V - Valor / Informação): Qual informação real este token carrega?
Na prática, o modelo compara a “pergunta” de cada palavra com a “etiqueta” de todas as outras, gerando uma pontuação de similaridade. Essas pontuações passam por uma normalização (a função Softmax) que as transforma em algo como percentuais de relevância — de 0% a 100% de atenção dedicada a cada palavra do texto. O resultado final combina essas porcentagens com o “conteúdo real” (Value) de cada token, gerando uma representação rica e contextualizada do texto.
As Três Famílias de Modelos Transformer
Nem todo Transformer é construído da mesma forma. A arquitetura original combinava duas metades: um Encoder (Codificador) e um Decoder (Decodificador). Com o tempo, a indústria ramificou-se em três especializações:
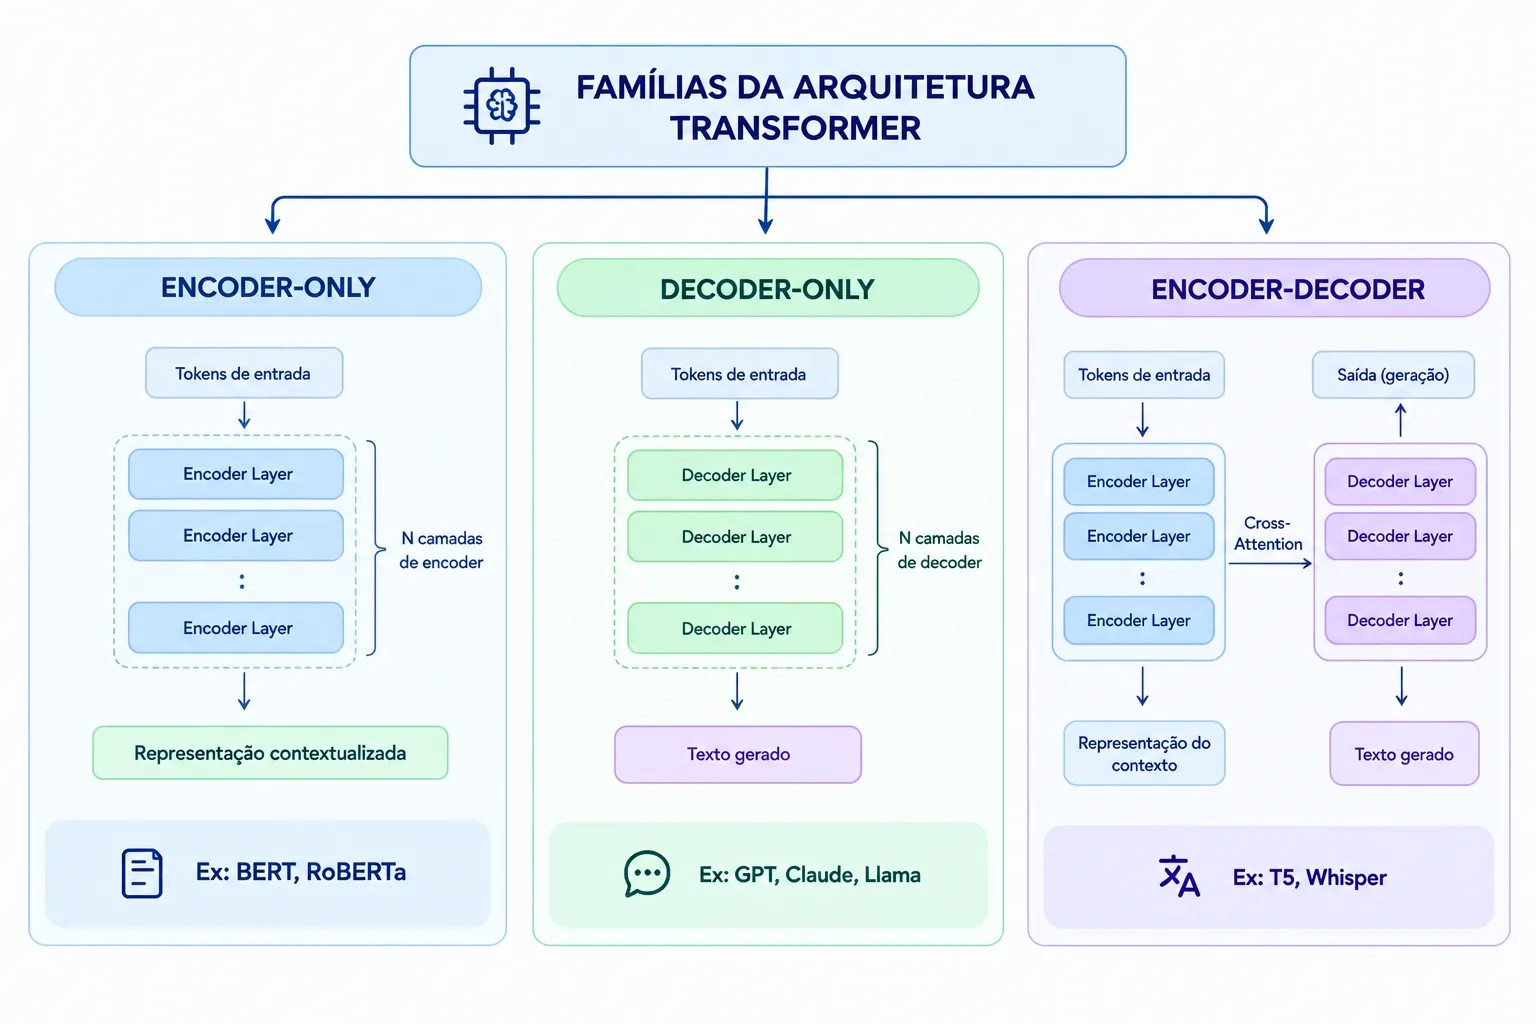
| Tipo de Arquitetura | Como Funciona | Ponto Forte | Casos de Uso Típicos |
|---|---|---|---|
| Encoder-Only | Lê o texto completo bidirecionalmente (olha para frente e para trás ao mesmo tempo). | Compreensão profunda de significado | Classificação de texto, busca semântica, detecção de sentimentos, embeddings |
| Decoder-Only | Processa de forma autorregressiva (olha apenas para os tokens passados para prever o próximo). | Fluência criativa, síntese e raciocínio | Modelos de conversa (ChatGPT, Claude, Gemini), geração de código |
| Encoder-Decoder | O Encoder lê a entrada inteira e o Decoder gera a saída passo a passo. | Mapeamento estruturado entre sequências | Tradução entre idiomas, sumarização de documentos extensos, áudio para texto |
O Ciclo de Vida de um Grande Modelo de Linguagem (LLM)
Construir um LLM moderno de ponta envolve quatro fases de engenharia computacional intensiva:
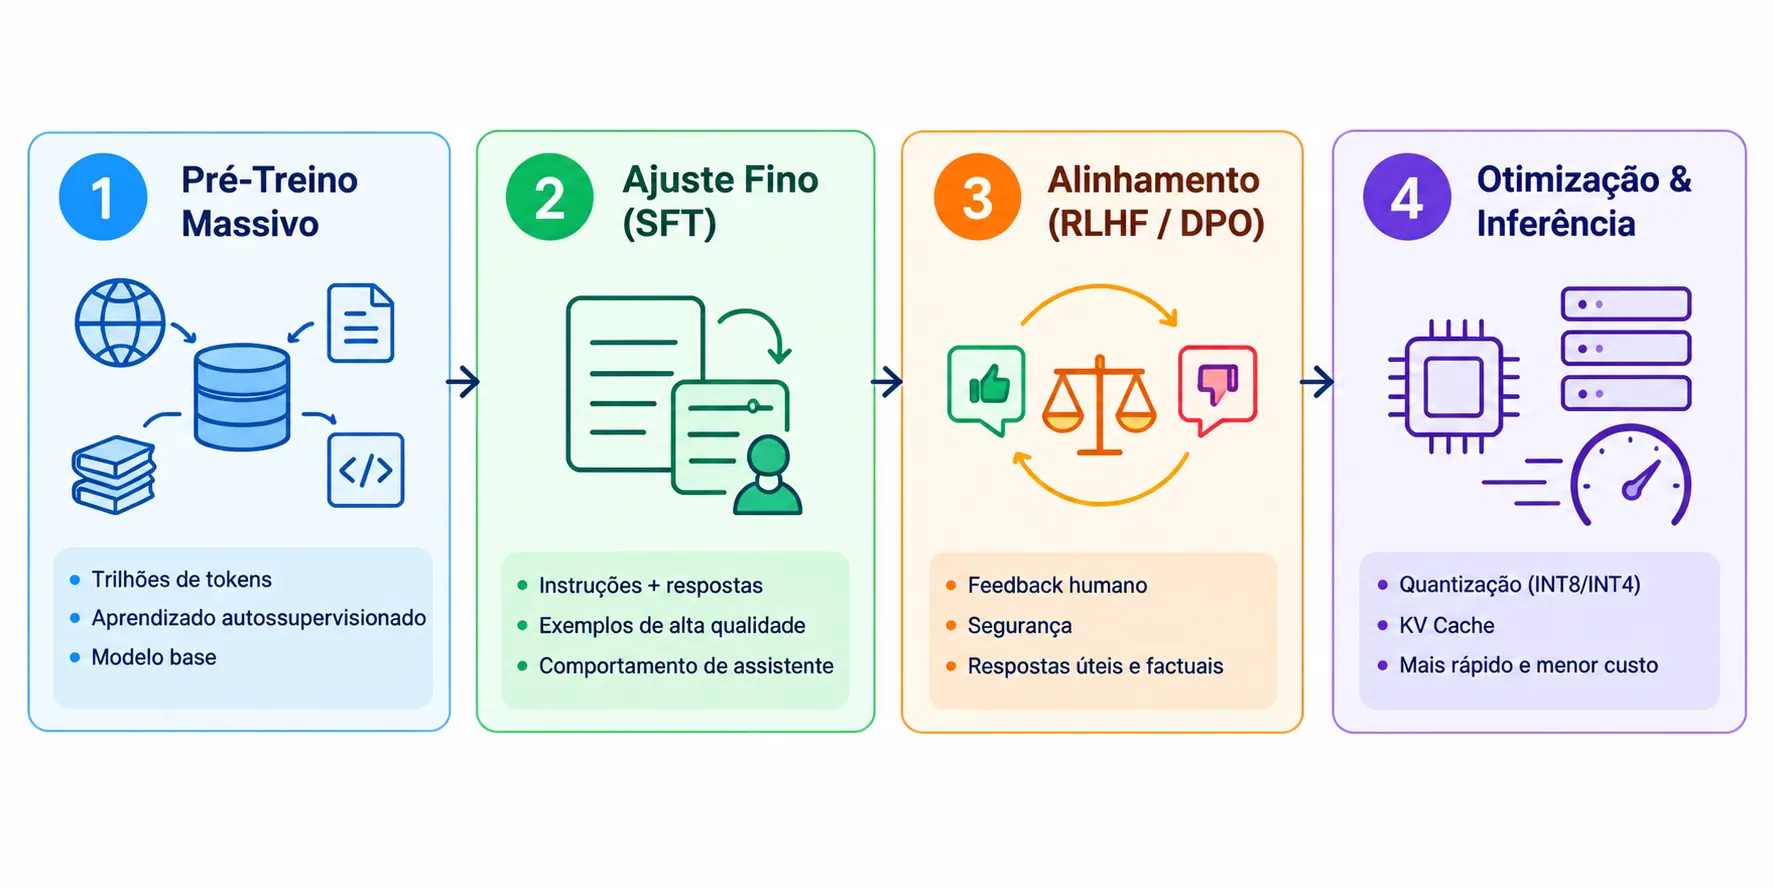
1. Pré-Treinamento Massivo (Pre-training)
O modelo é alimentado com trilhões de tokens da internet pública, livros e códigos-fonte abertos. Ele aprende gramática, fatos do mundo, lógica e código através do objetivo de prever o próximo token (Self-Supervised Learning). Esta fase consome milhares de GPUs ao longo de meses e custa milhões de dólares. O resultado é o modelo base (Base Model).
2. Ajuste Fino Supervisionado (SFT — Supervised Fine-Tuning)
O modelo base recebe dezenas de milhares de exemplos de alta qualidade no formato de instruções (Pergunta do Usuário → Resposta Ideal de Especialista), aprendendo a se comportar como um assistente prestativo.
3. Alinhamento de Preferências (RLHF e DPO)
Fase em que o modelo é calibrado com feedback humano para garantir que recuse pedidos prejudiciais (criação de malwares, armas biológicas) e priorize respostas claras, equilibradas e factualmente consistentes.
4. Otimização para Produção (Quantização e Cache)
Para que o modelo rode rápido e com menor custo em servidores reais:
- Quantização (INT8 / FP8 / INT4): Redução da precisão dos números dos pesos sem perda perceptível de qualidade. Converter pesos de FP16 para INT4, por exemplo, reduz o consumo de memória VRAM em cerca de 75% — um modelo de 70B que ocupa ~140 GB em FP16 passa a caber em ~35 GB (Hugging Face Optimum).
- KV Caching (Key-Value Cache): Armazena as chaves e valores dos tokens anteriores na memória para não recalcular a atenção de toda a frase a cada novo token gerado.
Desafios Computacionais e as Leis de Escala (Scaling Laws)
O custo computacional do mecanismo de autoatenção cresce de forma quadrática com o tamanho do texto: como cada palavra precisa ser comparada com todas as outras, dobrar o tamanho do prompt não dobra o esforço computacional — ele quadruplica.
Para viabilizar janelas de contexto de 1 milhão ou 2 milhões de tokens nos modelos atuais, a engenharia desenvolveu otimizações fundamentais:
- FlashAttention: Algoritmo que reestrutura os cálculos de atenção para explorar a memória rápida da GPU (SRAM), reduzindo drasticamente o tempo de leitura e escrita.
- Atenção Agrupada (GQA / MQA): Em vez de cada “cabeça” de consulta manter sua própria tabela de chaves e valores, várias cabeças passam a compartilhar as mesmas. O KV Cache encolhe drasticamente e a geração acelera — recurso padrão nos LLMs de fronteira atuais.
- Mixture of Experts (MoE): Em vez de uma rede única gigante processando todo token, o modelo contém múltiplos “especialistas” e um roteador ativa apenas alguns por token. É assim que modelos com centenas de bilhões de parâmetros operam rápido, pagando o custo computacional de uma fração da rede a cada resposta.
- Modelos de Raciocínio (Reasoning Tokens): Como os modelos da série o da OpenAI, Claude com raciocínio estendido e DeepSeek-R1, que usam “tokens de pensamento” intermediários para planejar deduções lógicas complexas antes de emitir a resposta final.
Perguntas Frequentes sobre Transformers
1. Por que a arquitetura Decoder-Only dominou o mercado de LLMs? Porque ela escala de forma muito mais eficiente durante o pré-treinamento não supervisionado e demonstrou a capacidade de generalizar para praticamente qualquer tarefa através do aprendizado no contexto (in-context learning).
2. Qual a diferença entre parâmetros e tokens?
- Tokens: São as palavras ou pedaços de palavras que entram e saem do modelo (os dados consumidos e gerados).
- Parâmetros: São os “pesos” matemáticos internos da rede neural (o conhecimento acumulado pelo modelo). Um modelo de 70B possui 70 bilhões de conexões numéricas ajustadas no treino.
3. O Transformer será substituído por outras arquiteturas (como Mamba ou RWKV)? Arquiteturas de espaço de estados (State Space Models — SSMs) como Mamba oferecem complexidade linear com o tamanho do texto e são promissoras, principalmente para contextos muito longos. Modelos híbridos que combinam atenção com camadas SSM, como o Jamba, já entregam custo de memória e velocidade de inferência bem menores mantendo qualidade competitiva — mas, em 2026, ainda tendem a ficar atrás dos Transformers puros de ponta em benchmarks gerais de raciocínio complexo (Lieber et al., 2024).
Conclusão
A arquitetura Transformer redefiniu a história da Inteligência Artificial ao substituir pipelines rígidos e sequenciais por um modelo flexível, altamente escalável e baseado no poder da atenção paralela.
Compreender como os Transformers calculam representações semânticas e operam a previsão de tokens é a chave para desmistificar as ferramentas de IA que utilizamos diariamente e antecipar os próximos saltos da computação cognitiva.
Explore a trilha completa de artigos para dominar todo o ecossistema de IA: