IA Generativa: O Que É, Como Funciona e a Revolução da Criação com Inteligência Artificial
Introdução
Durante mais de seis décadas, o desenvolvimento da Inteligência Artificial esteve predominantemente focado em uma missão: analisar, classificar e prever. Se você acompanhou nossos artigos sobre o que é Inteligência Artificial, os fundamentos do Machine Learning e as arquiteturas de Deep Learning, viu como as redes neurais se tornaram imbatíveis em detectar fraudes financeiras, transcrever áudios e diagnosticar doenças a partir de exames clínicos.
Entretanto, nos últimos anos, presenciamos uma das transformações mais disruptivas da história da computação: a transição dos modelos analíticos para os modelos generativos.
Pela primeira vez, sistemas digitais não apenas identificam padrões existentes, mas sintetizam artefatos inéditos — textos articulados, linhas de código funcionais, imagens com realismo fotográfico, voz com expressividade humana e até estruturas moleculares complexas.
Neste guia completo, você entenderá o que define a IA Generativa sob o ponto de vista conceitual e técnico, quando essa transformação começou, como seus principais motores funcionam por dentro (de Transformers a Modelos de Difusão), como escrever instruções melhores para eles, como ela se posiciona no ecossistema de software atual e quais são os desafios éticos e operacionais que moldam seu futuro.
O Que É IA Generativa?
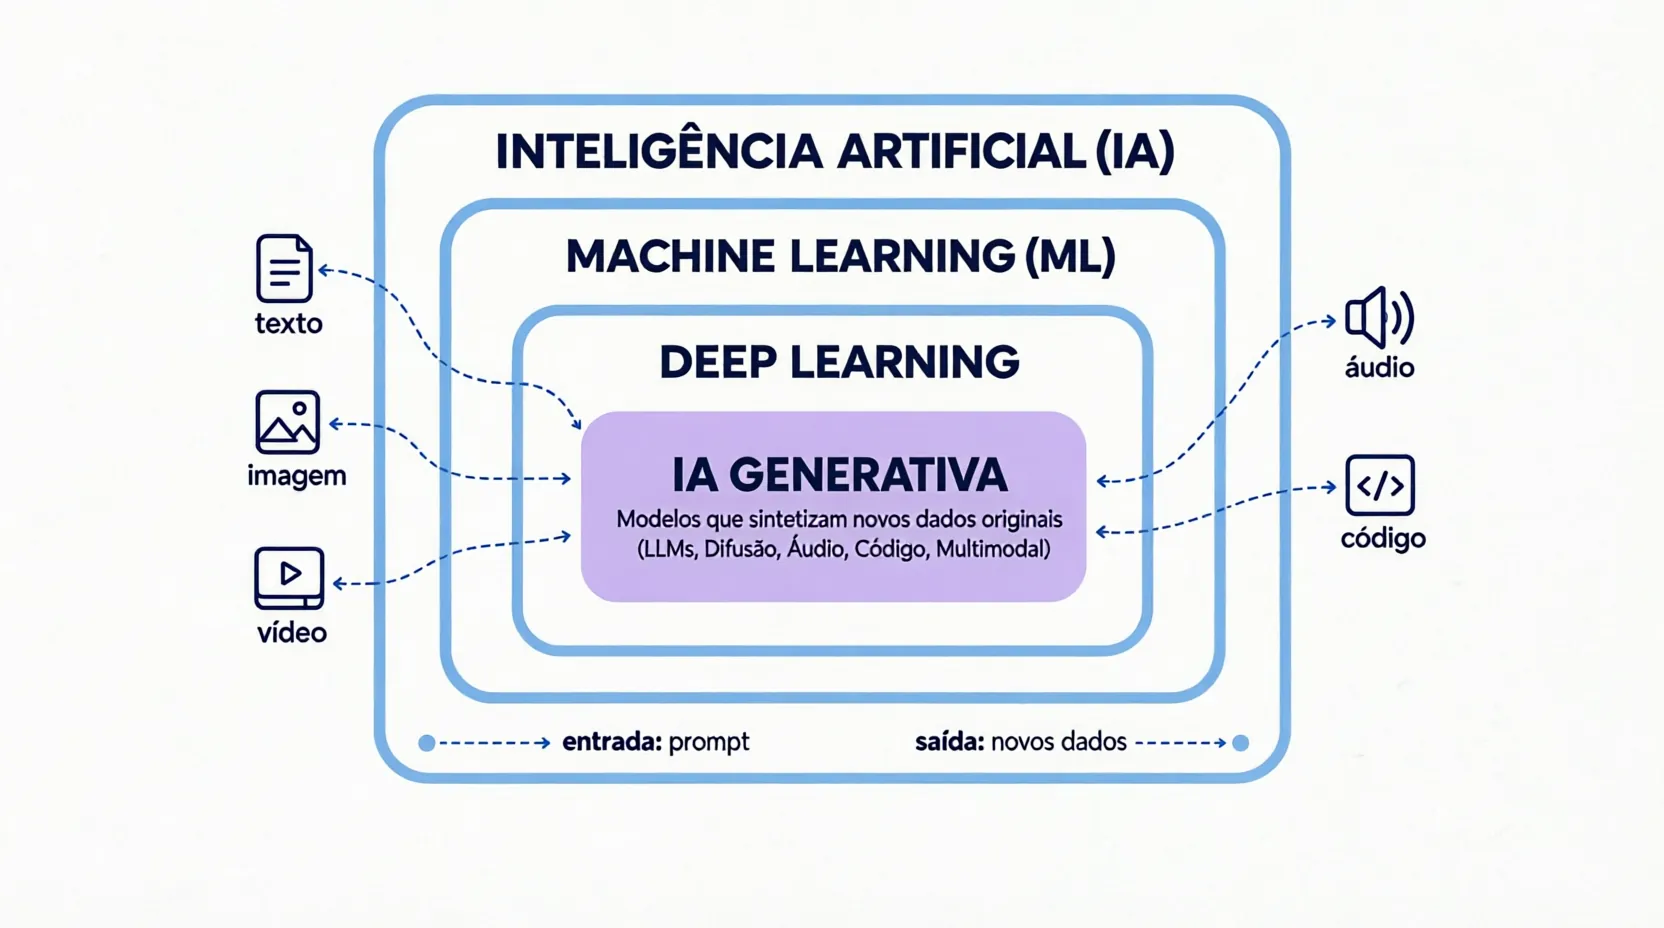
A Inteligência Artificial Generativa (GenAI) é um ramo do Deep Learning composto por algoritmos capazes de gerar novos dados que compartilham as características estatísticas e semânticas da base com a qual foram treinados, mas que não são cópias idênticas de nenhum item específico do conjunto de treino.
Em termos simples: enquanto a IA clássica responde a perguntas sobre dados existentes, a IA generativa produz novos dados a partir de intenções expressas em linguagem natural (conhecidas como prompts).
Uma Breve História da IA Generativa
A ideia de gerar conteúdo sinteticamente é mais antiga do que o ChatGPT. Em 2014, as Redes Adversariais Generativas (GANs) mostraram que era possível treinar dois modelos competindo entre si — um gerando imagens falsas, outro tentando detectá-las — até o gerador produzir resultados convincentes. Foi a primeira vez que “IA cria uma imagem realista do zero” saiu do papel.
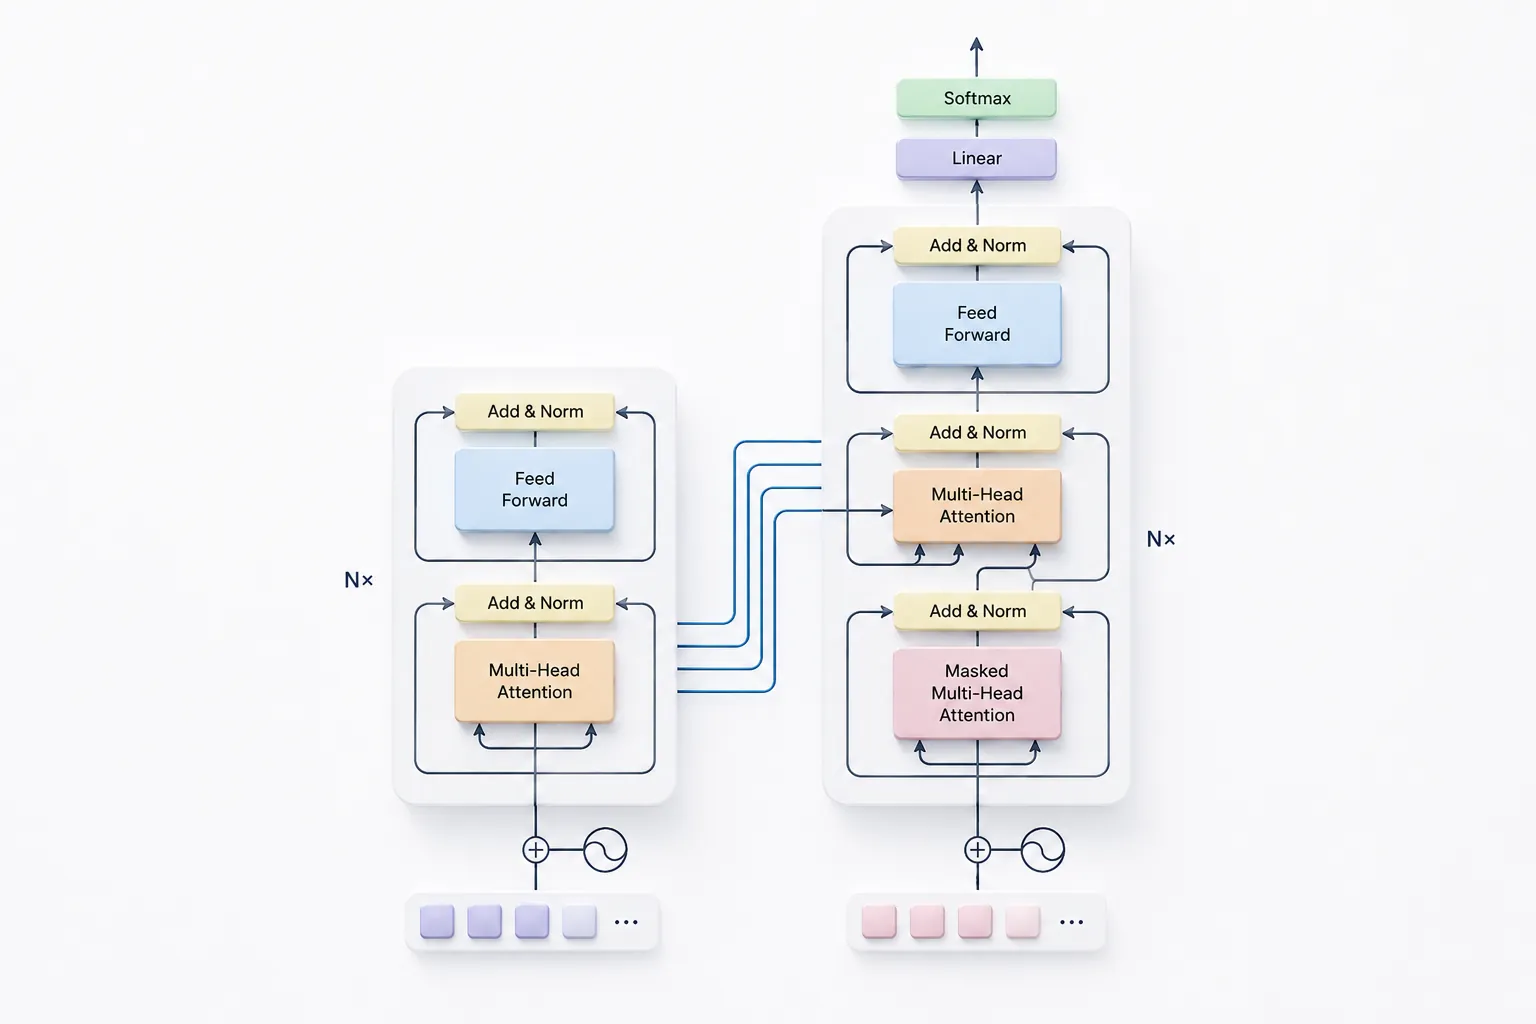
O salto seguinte veio da linguagem. Em 2017, o artigo “Attention Is All You Need” introduziu a arquitetura Transformer, base técnica de tudo que veio depois — inclusive da própria sigla GPT (Generative Pre-trained Transformer). Entre 2018 e 2020, a OpenAI publicou as três primeiras gerações de GPT, cada uma treinada com mais dados e parâmetros que a anterior. Em paralelo, os modelos de difusão superaram as GANs em qualidade e estabilidade de treinamento para geração de imagem.
O ano de 2022 concentrou as duas frentes: Stable Diffusion e Midjourney popularizaram a geração de imagem por texto, e o lançamento do ChatGPT, em novembro, popularizou a geração de texto conversacional em massa — pela primeira vez, IA generativa deixou de ser experiência de laboratório e virou hábito de trabalho para o público em geral. De 2023 a 2025, a corrida se voltou para modelos multimodais nativos e para os primeiros modelos de raciocínio, treinados para “pensar” em etapas antes de responder. Em 2025 e 2026, o centro de gravidade se deslocou para os agentes autônomos — o tema que fecha este guia.
A Virada de Paradigma: IA Discriminativa vs. IA Generativa
Para compreender a essência da IA Generativa, é fundamental contrastá-la com o paradigma anterior:
1. Modelos Discriminativos ($P(Y|X)$)
A maioria dos modelos tradicionais de Machine Learning busca traçar fronteiras de decisão entre classes. Eles aprendem a probabilidade condicional de uma classe $Y$ dado um conjunto de variáveis de entrada $X$.
- Objetivo: Diferenciar, rotular ou estimar um valor.
- Exemplo: Recebe uma foto de um veículo e calcula:
87% probabilidade de ser um carro,13% de ser um caminhão.
2. Modelos Generativos ($P(X)$ ou $P(X|Y)$)
Em vez de apenas traçar uma linha divisória entre classes, os modelos generativos aprendem a distribuição de probabilidade subjacente de todos os dados. Eles entendem como os elementos que formam um carro (rodas, reflexos, simetria, sombras) coexistem no espaço geométrico e estatístico.
- Objetivo: Sintetizar novas amostras coerentes com essa distribuição.
- Exemplo: Recebe a instrução “Gere uma foto em alta resolução de um carro elétrico esportivo em uma estrada litorânea ao entardecer” e constrói a matriz de pixels do zero.
| Característica | IA Discriminativa / Preditiva | IA Generativa |
|---|---|---|
| Função Principal | Classificar, filtrar, prever tendências | Criar texto, mídia, código, áudio e 3D |
| Formato de Saída | Rótulo, pontuação (score) ou valor numérico | Conteúdo multimídia complexo e contextual |
| Dependência de Dados | Requer dados anotados/rotulados | Pré-treinada em volumes massivos não rotulados |
| Exemplos Típicos | Detecção de spam, pontuação de crédito | ChatGPT, Claude, Midjourney, Flux, Whisper |
Como a IA Generativa Funciona por Dentro?
A capacidade de gerar respostas criativas e naturais não decorre de consciência ou compreensão humana, mas sim de um conjunto sofisticado de princípios matemáticos e de engenharia de software:
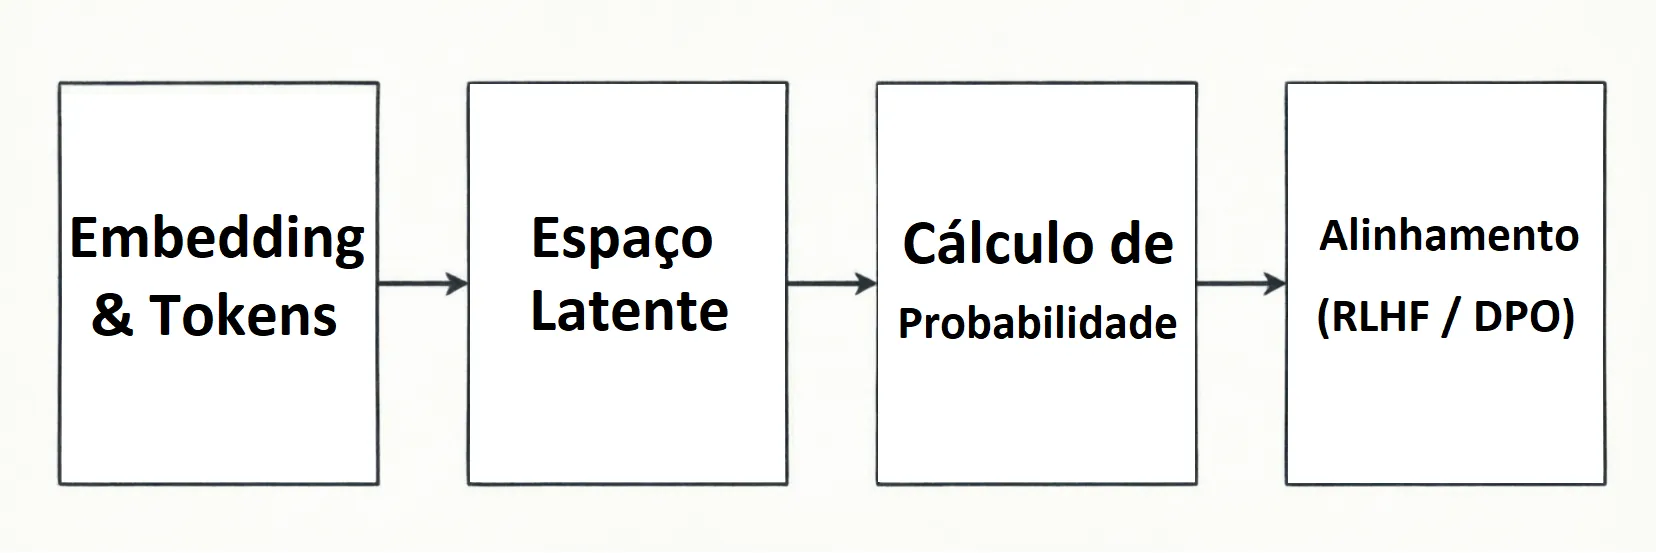
1. Tokenização e Embeddings
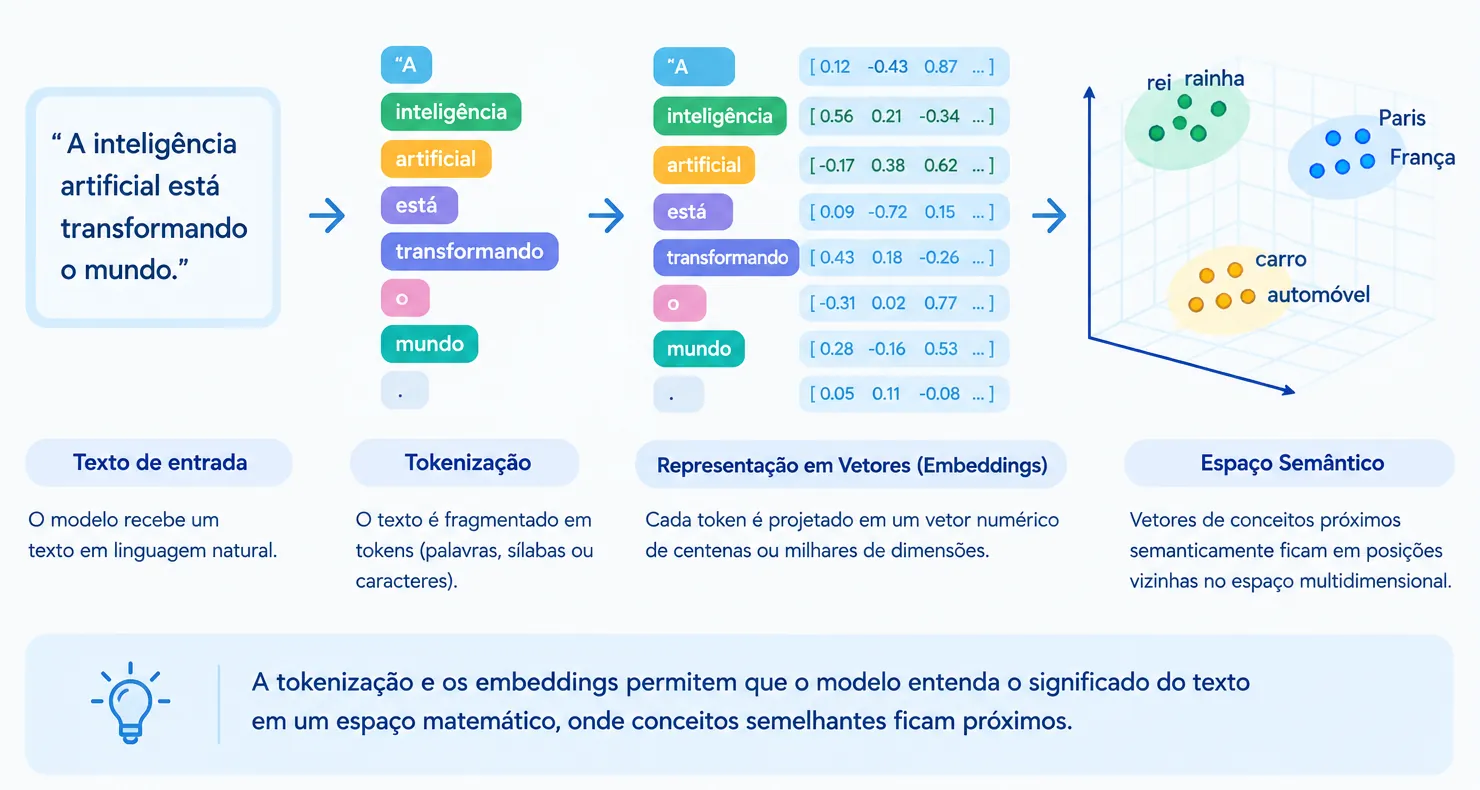
Modelos de linguagem não leem palavras diretamente. O texto de entrada é fragmentado em unidades mínimas chamadas tokens (que podem ser palavras inteiras, sílabas ou caracteres).
Em seguida, cada token é projetado em um vetor numérico de centenas ou milhares de dimensões (embedding). Vetores que representam conceitos próximos semanticamente (como “rainha” e “rei”, ou “Paris” e “França”) ocupam posições geométricas vizinhas nesse espaço multidimensional.
2. O Espaço Latente (Latent Space)
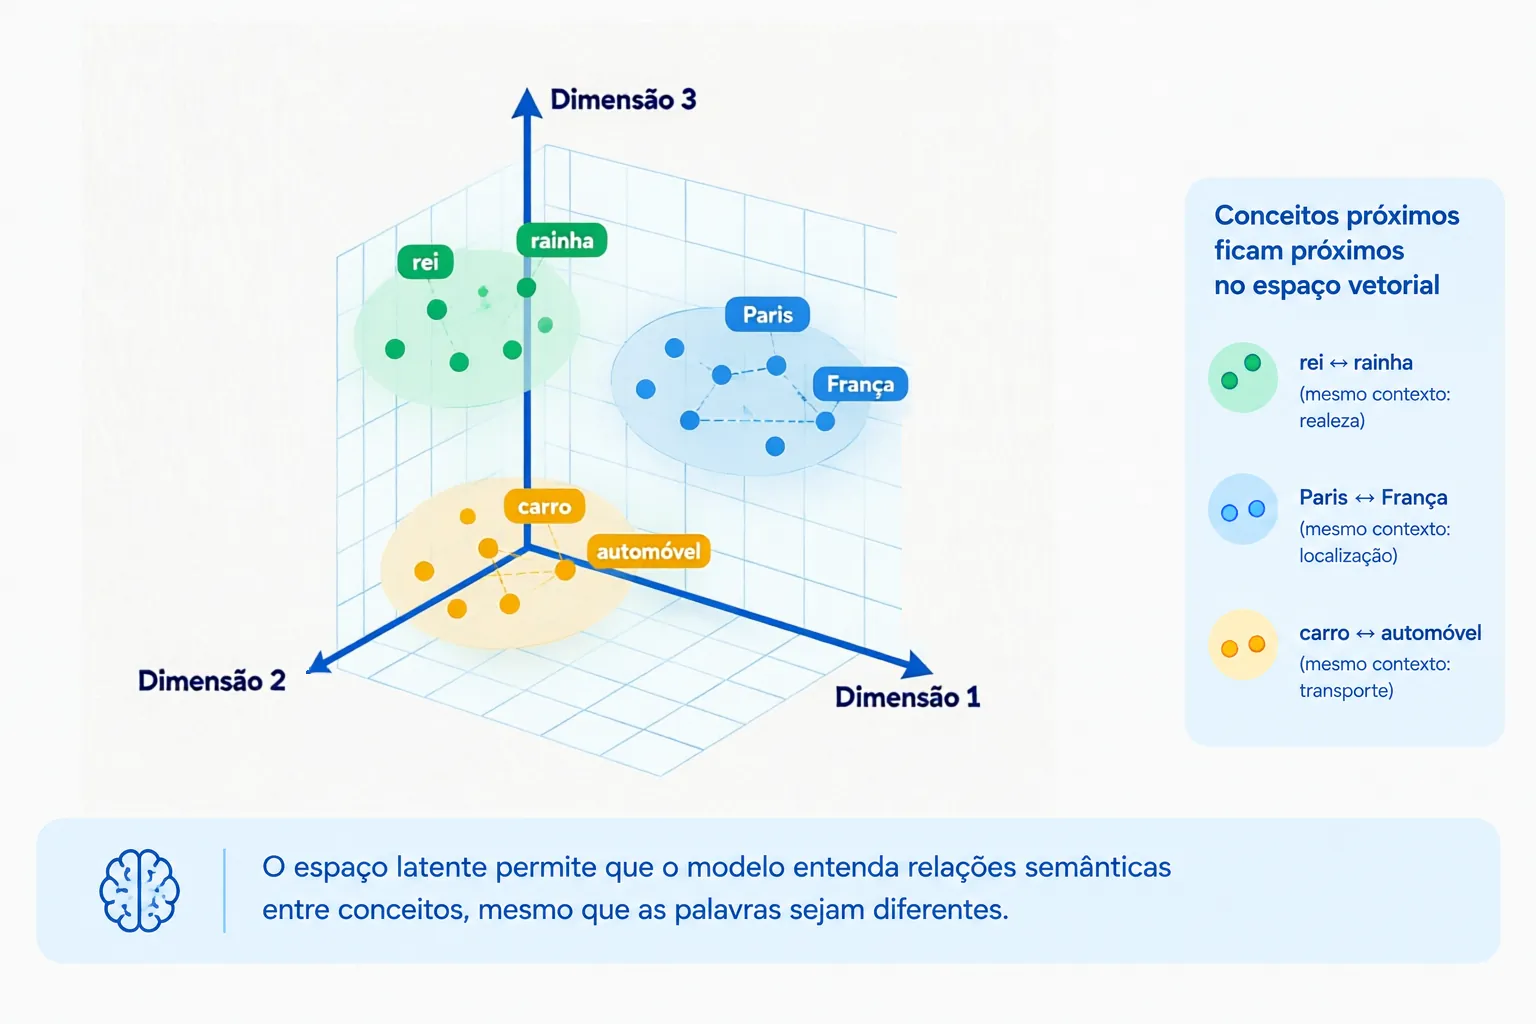
O espaço latente é uma representação matemática comprimida onde o modelo armazena os padrões abstratos do mundo. Ao sintetizar uma resposta ou uma imagem, o modelo navega por essas coordenadas vetoriais, traduzindo conceitos abstratos de volta para formatos legíveis por humanos.
3. Previsão Probabilística de Sequência
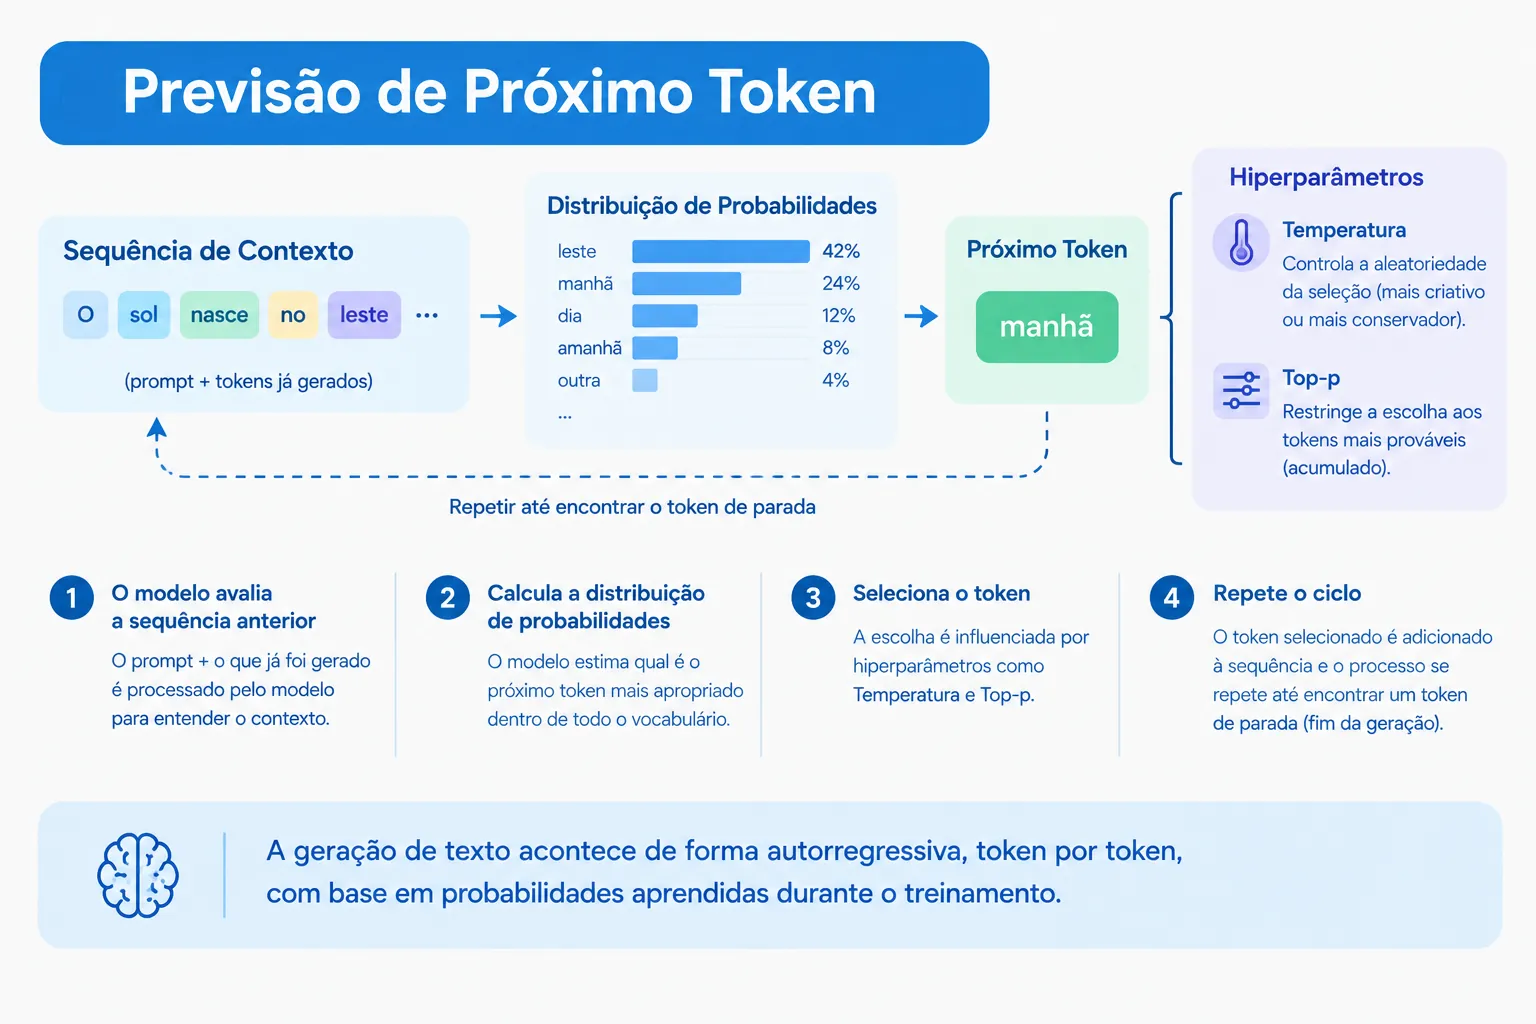
No caso dos Grandes Modelos de Linguagem (LLMs), a geração opera como um processo autorregressivo contínuo:
- O modelo avalia toda a sequência anterior (o prompt + o que já foi gerado).
- Calcula uma distribuição de probabilidades sobre todo o vocabulário para determinar qual é o próximo token estatisticamente mais apropriado.
- Seleciona o token (influenciado por hiperparâmetros como Temperatura e Top-p) e repete o ciclo até encontrar um token de parada.
4. Alinhamento e Refinamento (RLHF e DPO)
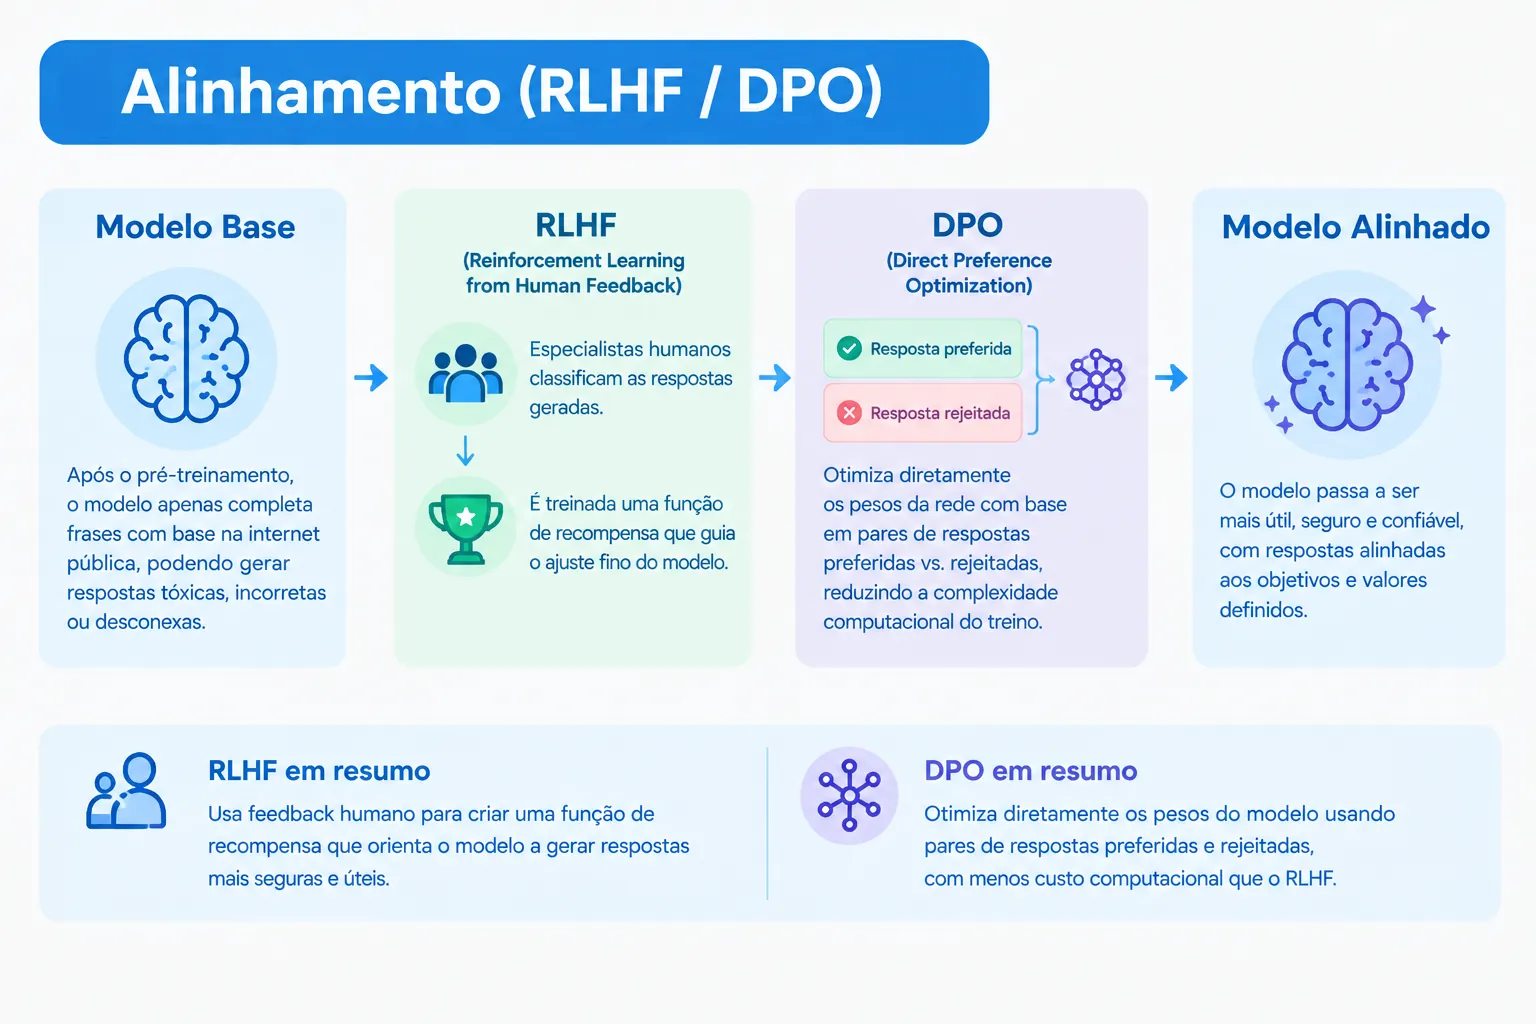
Um modelo recém-saído do pré-treinamento (base model) apenas completa frases de acordo com a internet pública — o que pode incluir respostas tóxicas, incorretas ou desconexas. Para torná-lo um assistente útil e seguro, aplica-se o Alinhamento:
- RLHF (Reinforcement Learning from Human Feedback): Especialistas humanos classificam diferentes respostas geradas, treinando uma função de recompensa que guia o ajuste fino do modelo.
- DPO (Direct Preference Optimization): Método mais recente que otimiza diretamente os pesos da rede com base em pares de respostas preferidas vs. rejeitadas, eliminando a necessidade de treinar um modelo de recompensa separado e simplificando o pipeline de alinhamento em relação ao RLHF tradicional.
As Principais Arquiteturas da Geração Moderna
Diferentes tipos de mídia demandam arquiteturas especializadas. As mais importantes do ecossistema são:
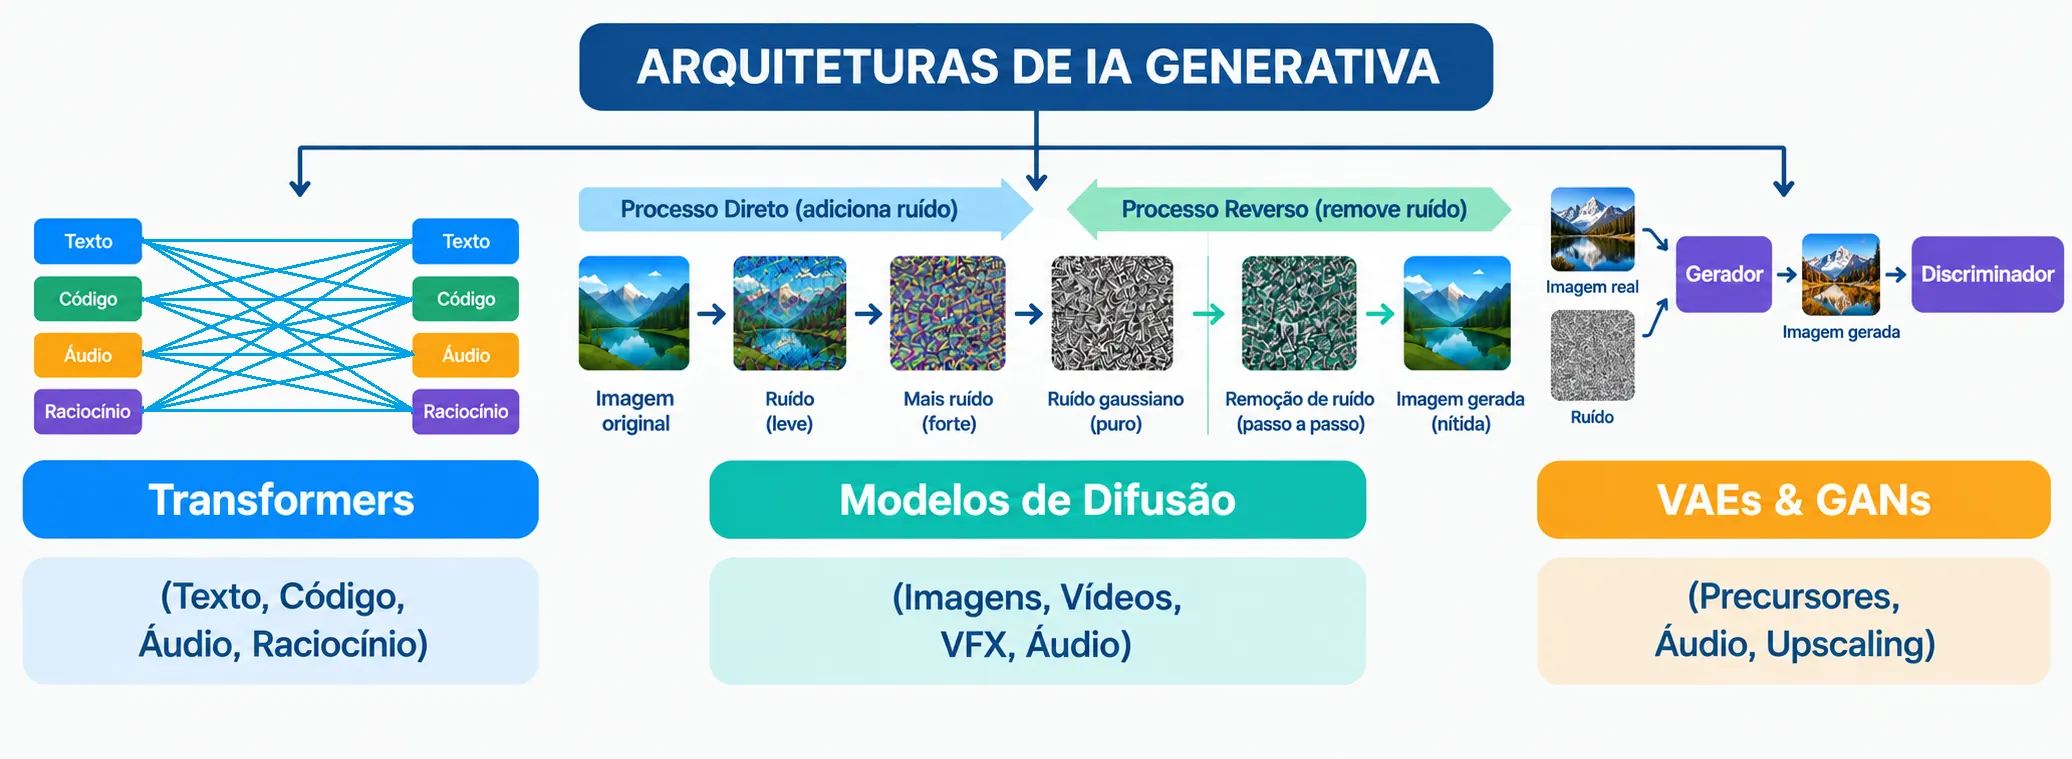
1. Arquitetura Transformer e Mecanismo de Atenção
Introduzida pelo célebre artigo “Attention Is All You Need” (Google, 2017), a arquitetura Transformer superou as limitações das redes recorrentes antigas através da Atenção Própria (Self-Attention).
Em vez de ler uma frase palavra por palavra sequencialmente, o Transformer processa todo o bloco de uma vez e calcula o grau de relacionamento entre todas as palavras da sentença, independentemente da distância entre elas. É a base de famílias de modelos como GPT, Claude, Gemini e Llama, cada uma em sua geração mais recente disponível a qualquer momento.
2. Modelos de Difusão (Diffusion Models)
Tornaram-se o padrão incontestável para geração de imagens e vídeos de altíssima fidelidade (como Stable Diffusion, Midjourney, Flux e Sora). Seu funcionamento baseia-se em dois passos:
- Processo Direto: Adiciona-se ruído estático (ruído gaussiano) progressivamente a uma imagem até transformá-la em estática pura.
- Processo Reverso: A rede neural aprende a prever e subtrair esse ruído passo a passo, reconstruindo uma imagem nítida a partir do ruído bruto, guiada pelas instruções do prompt.
3. GANs (Generative Adversarial Networks) e VAEs
Embora menos predominantes para síntese de texto, as Redes Adversárias Generativas (compostas por um Gerador que cria amostras e um Discriminador que tenta descobrir se são reais ou falsas) e os Variational Autoencoders continuam cruciais para upscaling, restauração de texturas, compressão de mídia e síntese de voz em tempo real.
Panorama de Ferramentas: O Que Escolher para Cada Tarefa
Não existe “o melhor modelo” de forma absoluta — existe o mais adequado para uma tarefa específica, um orçamento e um nível de exigência de precisão.
| Ferramenta | Arquitetura de base | Melhor uso |
|---|---|---|
| ChatGPT (OpenAI) | Transformer | Uso geral, ecossistema amplo de plugins |
| Claude (Anthropic) | Transformer | Textos longos, raciocínio cuidadoso, código |
| Gemini (Google) | Transformer multimodal | Pesquisa atualizada, integração com Workspace |
| Llama (Meta) | Transformer open-weight | Projetos que exigem controle total do modelo |
| Midjourney / Flux | Difusão | Arte conceitual, ilustração de alta estética |
| Stable Diffusion | Difusão open-source | Geração de imagem com controle técnico fino |
| ElevenLabs | GAN/VAE + Transformer | Clonagem e síntese de voz em tempo real |
Ao avaliar uma ferramenta, três critérios pesam mais do que “qual é mais famosa”: o tamanho da janela de contexto (quanto texto ela processa de uma vez), se o modelo é fechado ou de pesos abertos, e o custo por uso em escala.
A Fronteira da IA Generativa: Além dos Chatbots Básicos
A indústria de tecnologia já ultrapassou a fase inicial dos assistentes de conversa simples. O ecossistema corporativo contemporâneo apoia-se em três pilares avançados:
1. RAG (Retrieval-Augmented Generation)
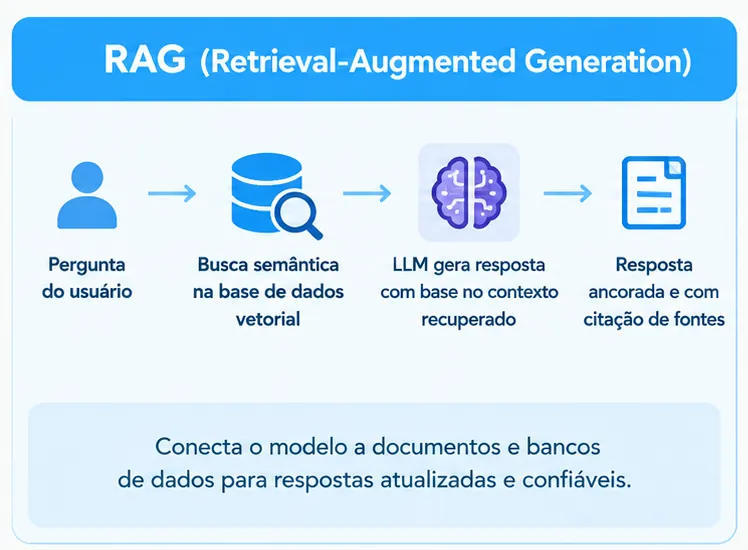
Os modelos têm um limite temporal de conhecimento e podem cometer alucinações sobre dados proprietários. O RAG resolve isso consultando um banco de dados vetorial antes de gerar a resposta:
- O usuário faz uma pergunta sobre um contrato interno ou documentação técnica.
- O sistema busca os trechos relevantes na base de dados corporativa via busca semântica.
- O contexto recuperado é injetado no prompt do LLM, que sintetiza uma resposta 100% ancorada nos fatos fornecidos, citando fontes com precisão.
2. Agentes Autônomos e Uso de Ferramentas (Tool Calling)
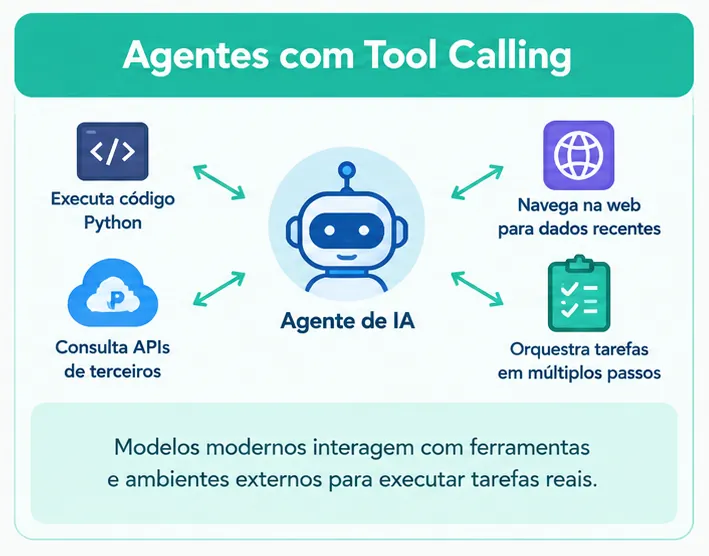
Modelos modernos não apenas produzem texto, mas conseguem interagir com ambientes externos:
- Escrever e executar código Python para gerar gráficos estatísticos sob demanda.
- Consultar APIs de terceiros (previsão do tempo, cotações, CRMs).
- Navegar na web para verificar dados recentes.
- Orquestrar tarefas em múltiplos passos de planejamento, validação e execução.
3. Modelos Pequenos e Especializados (SLMs)
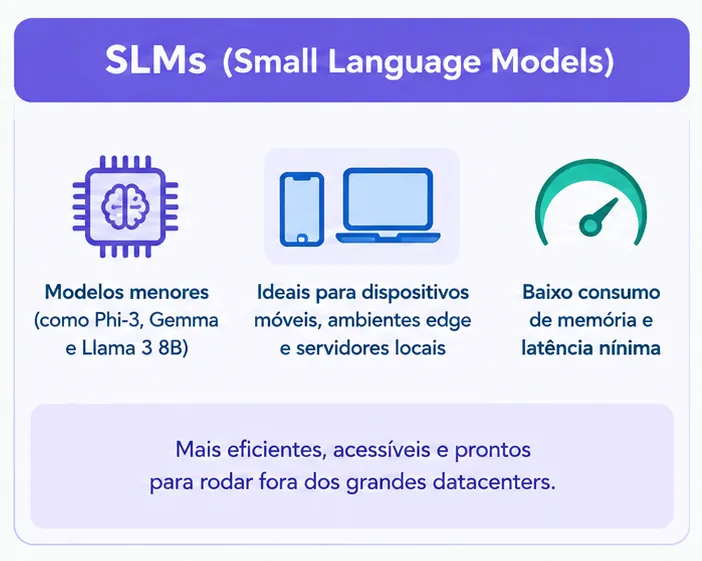
Enquanto modelos de centenas de bilhões de parâmetros rodam em datacenters gigantescos, os SLMs (Small Language Models) como Phi-3-mini, Gemma 2B e Llama 3.2 3B trazem eficiência surpreendente para dispositivos móveis, ambientes edge e servidores locais, com baixo consumo de memória e latência mínima.
Fundamentos de Prompt Engineering
Escrever um bom prompt não é sobre decorar fórmulas prontas — é sobre reduzir a ambiguidade que o modelo teria que adivinhar sozinho. Alguns princípios se sustentam independentemente da ferramenta:
- Contexto explícito: informar o objetivo, o público-alvo e restrições relevantes (tom, tamanho, formato) reduz a chance de o modelo preencher essas lacunas com suposições erradas.
- Exemplos (few-shot): mostrar um ou dois exemplos do resultado esperado costuma funcionar melhor do que apenas descrever o resultado em abstrato.
- Decomposição em etapas: pedir para o modelo “pensar passo a passo” antes de responder tende a melhorar a precisão em tarefas que envolvem lógica, matemática ou múltiplas condições — é literalmente o que os modelos de raciocínio fazem de forma nativa.
- Iteração: a primeira resposta raramente é a versão final — refinar o prompt com base no que saiu errado é parte do processo, não um sinal de que a ferramenta falhou.
Essa é a camada técnica do prompt. Como esses princípios se aplicam ao dia a dia de quem já trabalha com IA integrada ao fluxo profissional é o tema do artigo IA Generativa no Trabalho.
Aplicações Reais nos Principais Setores
O impacto da IA Generativa estende-se por praticamente todas as disciplinas do conhecimento:
- Engenharia de Software: Autocompletação de código, geração de suítes de testes unitários, detecção de vulnerabilidades e migração automatizada de linguagens legadas (conforme exploramos em profundidade no artigo sobre o impacto da IA Generativa no Trabalho).
- Medicina e Biotecnologia: Geração de novas sequências de anticorpos, simulação de interações entre moléculas para fármacos inéditos e sumarização automática de prontuários médicos.
- Design, Áudio e Audiovisual: Criação de storyboards, renderização de protótipos de produtos em minutos, localização de dublagens com sincronia labial e geração de trilhas sonoras adaptativas.
- Educação: Geração de exercícios personalizados e explicações adaptadas ao nível do aluno, sob demanda.
- Atendimento e Suporte ao Cliente: Agentes conversacionais capazes de resolver problemas complexos com empatia, contexto histórico e integração transacional com sistemas de logística e faturamento.
Desafios Técnicos, Éticos e Regulatórios
Apesar do seu potencial sem precedentes, a IA Generativa introduz desafios críticos que exigem governança e monitoramento contínuo:
1. Alucinações (Hallucinations)
Como operam por coerência estatística e não por checagem lógica de fatos, modelos podem gerar afirmações falsas com tom extremamente convincente. A mitigação exige arquiteturas com RAG, limites de temperatura e validações determinísticas — mas nenhuma técnica atual elimina o risco por completo.
2. Direitos Autorais e Dados de Treinamento
A utilização de vastos acervos da internet pública para treinar modelos abriu debates jurídicos globais sobre Fair Use (uso justo), remuneração de criadores originais e o direito de exclusão (opt-out) de dados protegidos — com decisões que ainda variam por país e por caso em disputa. Em paralelo, órgãos de registro de direitos autorais de vários países têm negado proteção a obras geradas inteiramente por IA sem intervenção criativa humana significativa, o que tem implicações práticas para uso comercial desse conteúdo.
3. Regulação
A União Europeia aprovou o AI Act, legislação que classifica sistemas de IA por nível de risco e impõe obrigações de transparência mais rígidas a modelos generativos de propósito geral. Outros países, incluindo o Brasil, têm projetos de lei em debate sobre o tema, ainda sem marco regulatório nacional consolidado.
4. Consumo Energético e Sustentabilidade
Tanto o treinamento de modelos de fronteira quanto a inferência em escala global demandam infraestrutura intensa de GPUs e alto consumo elétrico e hídrico para refrigeração de data centers, estimulando pesquisas em técnicas de quantização (como INT4 e FP8) e hardware neural dedicado.
5. Riscos de Segurança e Desinformação
A proliferação de clonagem de voz, deepfakes hiper-realistas e tentativas de Prompt Injection (onde invasores manipulam as instruções de segurança do sistema) exige novas camadas de cibersegurança e auditoria de modelos.
Perguntas Frequentes
Qual a diferença entre um LLM e o ChatGPT? LLM (modelo de linguagem de grande porte) é a tecnologia subjacente — o modelo treinado para prever texto. ChatGPT é um produto: uma interface de chat construída sobre um LLM (o GPT), com etapas adicionais de alinhamento para funcionar como assistente conversacional.
É possível eliminar completamente as alucinações? Não, com as técnicas atuais. É possível reduzir significativamente o risco — ancorando respostas em fontes verificáveis via RAG e com revisão humana em contextos críticos —, mas nenhum modelo garante 100% de precisão factual.
Modelos abertos (open-weight) são tão bons quanto os fechados? A distância técnica entre os dois vem diminuindo, mas modelos fechados de fronteira ainda costumam liderar em benchmarks de raciocínio complexo. A escolha envolve trade-offs de custo, controle e privacidade, não apenas desempenho bruto.
Preciso saber programar para usar IA generativa? Não, para a maioria dos usos — interfaces de chat e geração de imagem são acessíveis via texto simples. Programação passa a ser necessária quando se quer integrar modelos a sistemas próprios via API ou construir agentes personalizados.
Resumo Comparativo: A Evolução da Trilha de IA
Para consolidar o aprendizado de toda a nossa série, veja como cada camada se conecta:
| Nível | Foco Principal | Exemplo de Aplicação | Saída Típica |
|---|---|---|---|
| Inteligência Artificial | Conceito amplo de máquinas simulando cognição | Sistemas especialistas, lógica fuzzy | Decisões e automações de processos |
| Machine Learning | Aprendizado de padrões a partir de dados | Filtragem de spam, scoring de crédito | Predições estatísticas e regressões |
| Deep Learning | Redes neurais profundas com extração automática | Reconhecimento facial, carros autônomos | Reconhecimento de padrões complexos |
| IA Generativa | Síntese de dados inéditos via modelos fundacionais | ChatGPT, Midjourney, Claude, Copilot | Texto, imagem, código e mídia sintética |
Conclusão
A Inteligência Artificial Generativa não representa apenas uma nova ferramenta de software; ela marca uma mudança estrutural na forma como a humanidade interage com a informação e desenvolve soluções.
Ao democratizar o acesso à capacidade de síntese e raciocínio contextual, a IA generativa posiciona-se não como uma substituta da criatividade e do discernimento humano, mas como uma camada amplificadora de produtividade, ideação e descoberta científica. O próximo ciclo — agentes autônomos, raciocínio em etapas, modelos rodando localmente — já está em andamento, e acompanhar como cada uma dessas frentes evolui é o que separa um uso superficial de um uso maduro dessa tecnologia.
Para continuar aprofundando seus conhecimentos sobre a tecnologia e suas ramificações práticas, confira os outros artigos da nossa trilha: